
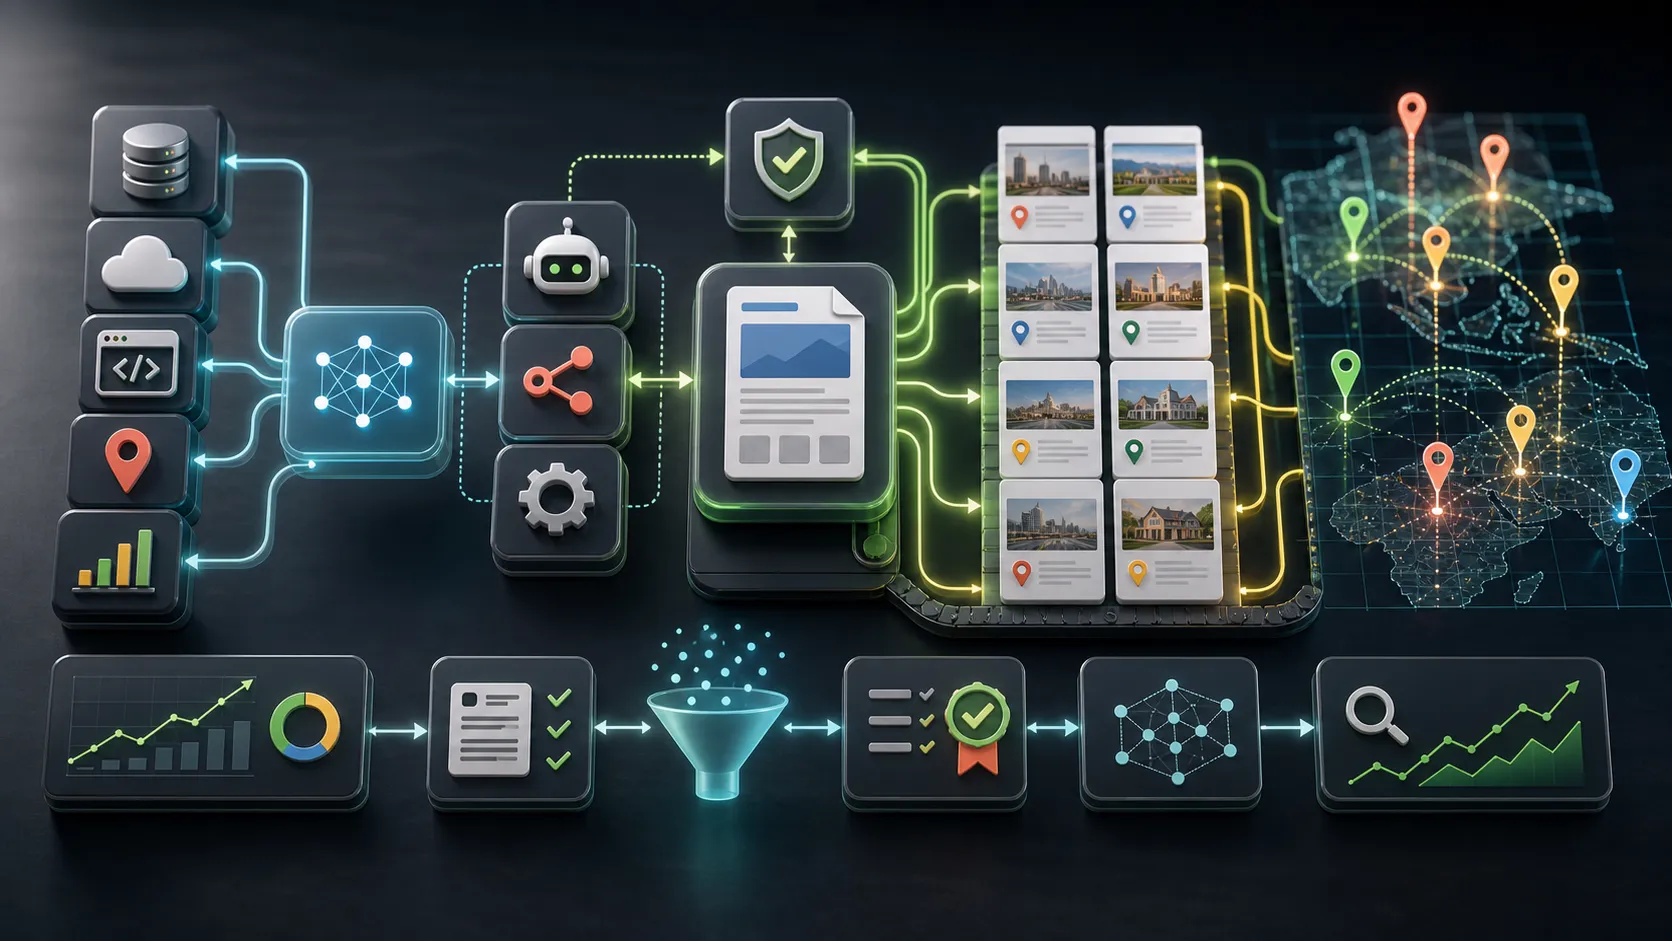
El SEO programático cambió. El modelo antiguo era simple: tomar una plantilla de landing page, cambiar la variable de servicio, ciudad, categoría o producto y publicar miles de URLs casi idénticas. Ese enfoque antes capturaba tráfico long-tail. Ahora es una responsabilidad y un riesgo.
Los sistemas modernos de búsqueda evalúan profundidad semántica, originalidad, experiencia y utilidad. Google AI Overviews, motores de respuesta como Perplexity y ChatGPT, y crawlers tradicionales recompensan contenido que puede ser parseado, confiado, citado y conectado con datos reales. Eso significa que el SEO programático ya no es principalmente un problema de producción de contenido. Es un problema de orquestación de datos.
La calidad a escala ahora exige una arquitectura técnica: fuentes de datos estructuradas, plantillas repetibles, workflows de automatización con IA, sistemas de SEO programático, SEO técnico y GEO, enlazado interno, schema, freshness loops y control de calidad humano.
Este artículo explica cómo construir SEO programático sin páginas thin, usando agentes de IA, workflows n8n, integraciones Model Context Protocol, datos geoespaciales localizados y páginas estáticas o server-rendered rastreables.
Introducción: el cambio arquitectónico en el descubrimiento de búsqueda
La optimización para motores de búsqueda pasó de coincidencia heurística de keywords hacia síntesis semántica impulsada por Large Language Models. Históricamente, el SEO programático implicaba generación masiva de landing pages cambiando keywords localizadas o variables genéricas dentro de una plantilla HTML estática. Aunque ese enfoque antes capturaba tráfico orgánico long-tail, los algoritmos contemporáneos y los motores de respuesta impulsados por IA volvieron obsoleto el templating de bajo esfuerzo.
Las guías actuales de calidad de búsqueda apuntan a páginas donde el contenido principal tiene poco esfuerzo, poca originalidad y poco valor añadido. En términos prácticos, una página que solo cambia el nombre de ciudad, etiqueta de industria o categoría de producto no es un activo SEO duradero. Es un riesgo de thin content.
Los motores modernos de descubrimiento usan sistemas de búsqueda neuronal y modelos de lenguaje para evaluar profundidad semántica, experiencia de primera mano y utilidad real. Google AI Overviews y la adopción de motores de respuesta introdujeron una disciplina operativa más nueva: Generative Engine Optimization, o GEO.
Dentro de este marco, el SEO programático todavía funciona, pero los requisitos mínimos son mucho más altos. Escalar visibilidad orgánica ahora exige pipelines de datos únicos, arquitectura técnica estructurada y workflows de IA que mantengan calidad en muchas URLs generadas.
Para empresas digitales y organizaciones de servicios que buscan crecimiento orgánico escalable, el objetivo ya no es la generación de contenido por sí sola. El objetivo es la orquestación de datos. Las estrategias modernas sintetizan automatización con IA, integraciones de bases de datos únicas y ejecución programática para producir activos de alto valor, orientados por intención y escalables.
Las mecánicas de Generative Engine Optimization
Para diseñar páginas programáticas de alta calidad, los arquitectos primero deben entender cómo los motores modernos de búsqueda generativa ingieren, procesan y citan contenido.
Generative Engine Optimization es la disciplina técnica y editorial de estructurar activos digitales para que las plataformas de IA puedan descubrir, ingerir, confiar y citar el contenido al sintetizar respuestas a consultas complejas de usuarios.
La transición de densidad de keywords a autoridad de citación
Los algoritmos tradicionales de búsqueda dependían mucho del targeting de keywords, autoridad de enlazado interno y perfiles de backlinks externos. Los motores generativos de respuesta operan más sobre extracción semántica de entidades y autoridad de citación.
Los motores generativos ensamblan respuestas mediante un pipeline de varios pasos:
- Descubren páginas mediante crawlers, feeds estructurados, sitemaps o protocolos como IndexNow.
- Parsean HTML bruto y schema JSON-LD para señales semánticas.
- Recuperan fragmentos de texto aislados relevantes para el prompt.
- Generan una respuesta sintetizada con citas hacia material fuente.
Esto cambia el objetivo de optimización. En lugar de apuntar solo a frases rígidas de keywords, el contenido programático debe mapear intención conversacional y ofrecer bloques factuales extraíbles. Los usuarios interactúan con motores de IA mediante prompts complejos de varias partes, no con fragmentos cortos de keywords.
Para convertirse en una fuente citada, el contenido programático necesita claridad modular. Bloques estructurados, pasos ordenados, afirmaciones concisas, tablas y respuestas directas facilitan que los sistemas de IA extraigan el pasaje correcto.

| Métrica operativa | Search Engine Optimization tradicional | Generative Engine Optimization |
|---|---|---|
| Señal principal de ranking | Posición orgánica | Visibility score y frecuencia de citas |
| Mecanismo principal de confianza | Domain rating y backlinks externos | Autoridad de citación y reconocimiento de entidades |
| Input estándar del usuario | Keywords fragmentadas, como “plumber Miami” | Prompts conversacionales e intención compleja |
| Benchmark central de éxito | Volumen total de tráfico y clics | Citas de IA, share of voice y menciones de marca |
| Formato óptimo de contenido | Narrativas long-form con colocación de keywords | Afirmaciones extraíbles, bloques estructurados y respuestas directas |
| Enfoque arquitectónico | Enlazado interno y jerarquías URL | Schema markup, integraciones API y llms.txt |
Análisis de criterios de selección de AI Overviews y métricas de rendimiento
La investigación empírica en SEO ha sugerido que las fuentes citadas dentro de Google AI Overviews suelen provenir de páginas que ya rankean bien en búsqueda orgánica tradicional. AI Overviews también se activan dinámicamente según la clasificación de la consulta. Aparecen con más frecuencia en intenciones informativas, preguntas complejas multifacéticas y consultas semánticas long-tail. Aparecen menos en algunas consultas altamente comerciales o transaccionales.
AI Overviews también cambiaron el comportamiento de clics de los usuarios. Algunos estudios de la industria han reportado menores tasas de click-through para listings orgánicos estándar cuando hay un AI Overview presente, mientras que las fuentes citadas pueden recibir más atención de clics que competidores no citados.
Estas cifras varían por tipo de consulta, layout SERP, intención comercial e industria. El punto estratégico es más estable que cualquier benchmark específico: una página de SEO programático no debe perseguir solo un ranking de enlace azul. Debe funcionar como un repositorio de datos estructurado y autoritativo que los sistemas de IA puedan usar para extracción de afirmaciones.
Eso exige precisión técnica. La estructura DOM, schema, enlaces internos, bloques factuales y arquitectura de base de datos deben apoyar tanto el parseo por máquinas como la utilidad humana.
Anatomía de arquitecturas programáticas de alta calidad
Para evitar thin content, la infraestructura programática debe entregar valor único en cada URL generada. La solución es dejar de girar texto y empezar a enriquecer datos.

Aprovechar fuentes de datos propietarias y únicas
La capa fundacional de calidad a escala es información propietaria o hiper-específica. En lugar de desplegar una plantilla con copy genérico de marketing y nombres de ciudades intercambiados, una página programática fuerte se convierte en una interfaz para datos localizados, reseñas verificadas de clientes, variables ambientales contextuales, datasets visuales dinámicos o inteligencia interna de negocio.
Fuentes útiles pueden incluir:
- Catálogos de productos con especificaciones y disponibilidad.
- Registros de servicios locales desde un CRM.
- Reseñas verificadas por servicio y ubicación.
- APIs municipales de datos abiertos.
- Datasets geoespaciales.
- Matrices de comparación.
- Datos de APIs de partners.
- Taxonomías de industria o categoría.
Por ejemplo, una arquitectura programática sofisticada podría agregar códigos locales de construcción, calcular costos promedio de servicio desde datos históricos de CRM, generar casos de estudio por vecindario e integrar patrones climáticos que crean demanda para servicios de mantenimiento.
Este enfoque data-first satisface el requisito central de contenido único y no commodity. La página deja de ser una plantilla de frases. Se convierte en una síntesis útil de información difícil de encontrar en otro lugar.
Diseñar e implementar el freshness loop
Las páginas programáticas estáticas se degradan cuando sus datos subyacentes quedan obsoletos. Para mantener relevancia, la arquitectura debe incluir un freshness loop.
Un freshness loop es un pipeline automatizado y cíclico donde fuentes de datos externas e internas se revisan de forma rutinaria para detectar actualizaciones. Cuando los datos cambian, los hechos, cálculos, resúmenes y módulos de página resultantes se actualizan sin una reescritura completamente manual.
Un workflow práctico puede verse así:
- Aparece un nuevo proyecto, reseña, permiso, listing o registro de servicio en una base de datos.
- El workflow recalcula estadísticas locales agregadas.
- Un agente de IA resume solo los datos proporcionados.
- El contenido generado se verifica contra reglas de calidad.
- Se publica el Markdown, HTML, fila de base de datos o entrada CMS actualizada.
- Se actualiza el sitemap o la señal de indexación.
Esto mantiene el contenido actual, mejora confianza y da a usuarios y crawlers una razón para volver a visitar la página.
Sistematizar señales de confianza y E-E-A-T a escala
Experience, Expertise, Authoritativeness y Trustworthiness son pilares críticos de evaluación en búsqueda moderna. Para escalar E-E-A-T en un despliegue programático, las señales explícitas de confianza deben integrarse en las plantillas centrales.
Señales clave de confianza incluyen:
- Atribución autoral dinámica: Vincular activos programáticos a subject matter experts verificados y respaldarlos con schema Person y Organization.
- Transparencia de citas: Mostrar enlaces visibles a endpoints de APIs, portales de datos del gobierno local o fuentes internas detrás de afirmaciones numéricas.
- Agregación y verificación de reseñas: Extraer reseñas verificadas hiperlocales y específicas por servicio para demostrar experiencia real de clientes.
- Fechas claras de actualización: Mostrar cuándo se revisó la página o cuándo se actualizó la información subyacente.
- Rutas de conversión específicas: Dar a los usuarios un siguiente paso práctico en lugar de dejarlos en una página informativa pasiva.
Localización basada en datos: uso de APIs de datos abiertos en Florida
Para organizaciones de servicios, equipos inmobiliarios y negocios locales, los datos cívicos y geoespaciales pueden enriquecer páginas programáticas con contexto local factual.
En lugar de escribir páginas genéricas de ciudad, un negocio puede consultar portales municipales de datos abiertos y construir landing pages que respondan preguntas locales específicas con evidencia.
Integración de portales de datos abiertos de Miami y Orlando
Los municipios de Florida ofrecen datasets públicos útiles para desarrolladores, investigadores y operadores de negocio. El City of Miami Developer Portal ofrece acceso a datasets cívicos mediante estrategias REST API, Esri Geoservices y formatos GeoJSON. El portal City of Orlando Open Data ofrece datasets como reportes de permisos, inventarios de lotes vacantes, parámetros de zoning y datos de seguridad pública.
Para una estrategia SEO en Florida, esto importa porque una página local puede construirse desde señales locales reales en lugar de lenguaje geográfico thin. Una página de SEO técnico en Miami, por ejemplo, puede ser más fuerte cuando conecta intención local, contexto de servicio y condiciones operativas factuales.
| Dataset municipal de Florida | Formato API disponible | Aplicación de SEO programático |
|---|---|---|
| Miami 311 Service Requests | API REST geoespacial | Identificar problemas hiperlocales de infraestructura y activar páginas para servicios de restauración, plomería, roofing o recuperación de desastres según clusters de incidentes. |
| Miami Building Permits | GeoJSON o REST | Agregar timelines de permisos comerciales y costos de construcción para guías inmobiliarias, construcción e inversión. |
| Miami 21 Zoning Data | ArcGIS Geoservice | Crear guías localizadas de propiedad comercial que se actualizan cuando cambian zonas transect o contexto de zoning. |
| Orlando Permitting Reports | Socrata Open Data API | Identificar zonas de desarrollo emergente y generar páginas de servicios B2B para nueva construcción comercial. |
| Orlando Vacant Lots Inventory | REST API | Apoyar páginas para desarrolladores, landscapers, empresas de mantenimiento de propiedades y operadores inmobiliarios. |
Arquitectura de caso de estudio: real estate comercial y construcción
Considera una firma de construcción o consultoría de real estate comercial que opera en South Florida. La organización puede usar datos de permisos de construcción de Miami, que incluyen atributos como fechas de aplicación, estado de procesamiento, costos estimados y timelines de revisión.
Una arquitectura avanzada de SEO programático podría consultar este dataset semanalmente para generar y actualizar insights específicos por vecindario. Las páginas resultantes podrían incluir:
- Datos agregados sobre tiempos promedio de permisos comerciales en zonas transect específicas de Miami.
- Referencias cruzadas a datos de zoning Miami 21.
- Mapas interactivos que muestran desarrollo reciente dentro de un radio definido.
- Resúmenes generados por IA de tendencias de construcción basados solo en datos brutos de costo y timeline desde la API.
Esto crea una página más fuerte que un artículo genérico de “commercial real estate Miami” porque responde una pregunta local real con datos actuales.
Arquitectura de caso de estudio: recuperación de desastres y mantenimiento de propiedades
Los negocios de servicios enfocados en roofing, plomería o restauración de propiedades pueden aplicar el mismo patrón a datos de Miami 311 service requests.
Al filtrar datos geoespaciales por ZIP codes o coordenadas específicas, un sistema automatizado de análisis puede identificar vecindarios con reportes concentrados de inundaciones, árboles caídos, fallas de infraestructura o problemas relacionados.
Las landing pages programáticas para esos vecindarios pueden referenciar datos locales empíricos y ofrecer servicios que respondan directamente a necesidades comunitarias verificadas. En Central Florida, los negocios pueden usar inventarios de lotes vacantes o reportes de permisos de Orlando para identificar zonas de desarrollo y crear páginas útiles para desarrolladores, equipos de mantenimiento y proveedores B2B.
Este enfoque produce páginas con densidad factual y originalidad local. Esa es la diferencia entre SEO local útil y doorway pages de bajo valor.
Automatizar el pipeline de producción con n8n y agentes de IA
Ejecutar integración de datos, cálculo estadístico y generación de contenido en muchas URLs exige infraestructura de orquestación. n8n encaja bien en operaciones SEO complejas y basadas en datos porque soporta lógica custom, JavaScript, self-hosting, integraciones API y diseño flexible de workflows.
A diferencia de herramientas SaaS rígidas de automatización, n8n da a equipos técnicos control granular sobre lógica de workflow, manejo de errores y custodia de datos. Esto importa cuando el sistema SEO programático necesita manejar datos propietarios de CRM, credenciales de APIs locales, datasets de búsqueda y credenciales de publicación.
Diseñar la arquitectura técnica del workflow
Un pipeline SEO programático de alta calidad en n8n normalmente usa varios agentes de IA y pasos de validación en secuencia.
- Ejecución del trigger y adquisición de datos: El workflow empieza desde un cron schedule o webhook. Un nodo HTTP Request obtiene datos desde una API objetivo, como un endpoint geoservice de Miami, export de Google Ads keywords, export de Search Console o CRM propietario.
- Análisis agentic de datos e identificación de gaps: El JSON bruto se parsea y pasa a un modelo de IA mediante una integración como LangChain. El agente está limitado por un system prompt estricto y se le pide identificar gaps de intención, patrones de competidores o módulos de página útiles desde los datos proporcionados.
- Síntesis de contenido y enforcement de formato: Un segundo nodo de IA crea el contenido de la página en secciones modulares enfocadas en respuestas, con headings H2 y H3 claros. La salida debe permanecer visible en HTML plano o Markdown, no enterrada en UI client-only.
- Generación de metadata e implementación de schema: Otro nodo genera title tags, slugs, meta descriptions y JSON-LD como schema FAQPage, Article, Organization o LocalBusiness.
- Quality assurance y human-in-the-loop routing: Antes de publicar, un sub-workflow de validación revisa cannibalization, presencia de schema, referencias a fuentes, campos requeridos, word count, duplicación y riesgo de alucinación. Los borradores de mayor riesgo se enrutan a un revisor humano en Slack, Teams o una cola CMS.
- Publicación e indexación algorítmica: Una vez validado, el workflow publica en un CMS, repositorio de sitio estático o base de datos. También puede actualizar el XML sitemap o enviar una señal de indexación.
| Categoría de nodo principal n8n | Función principal en SEO programático |
|---|---|
| Nodos Webhook y Cron | Iniciar el freshness loop según intervalos de tiempo, cambios en base de datos o eventos externos. |
| Nodos HTTP Request | Obtener datos geoespaciales brutos desde APIs de datos abiertos de Florida o herramientas SEO externas. |
| Nodos LangChain y AI Agent | Procesar datos, realizar análisis de gaps SERP y sintetizar HTML o Markdown modular. |
| Nodos PostgreSQL y Supabase | Consultar la base de datos interna para prevenir cannibalization de keywords y registrar URLs publicadas. |
| Nodos de comunicación | Enrutar activos generados a editores humanos para QA final y aprobación. |
Esta infraestructura reduce el overhead manual de operaciones de contenido grandes y ayuda a capturar intención long-tail sin depender de un equipo tradicional de alto volumen de contenido. Para equipos que necesitan ayuda conectando automatización segura, API keys y manejo de errores, automatización de workflows con IA se vuelve parte de la arquitectura SEO, no una herramienta operativa separada.
Mitigar las desventajas de plataformas de automatización
Las plataformas de automatización y agentes de IA crean leverage, pero también introducen riesgo operativo. Los community nodes pueden romperse después de actualizaciones de plataforma. Los jobs grandes de análisis pueden exceder ventanas de contexto de modelos. Prompts vagos pueden producir consejos genéricos en lugar de output útil.
El sistema nunca debe depender del modelo de lenguaje para inventar hechos desde sus datos de entrenamiento. Usa el modelo como motor de razonamiento, categorización y formato. Restringe el modelo a los datos cívicos, propietarios o derivados de APIs suministrados en el workflow.
La supervisión humana sigue siendo no negociable. Los agentes de IA deben manejar investigación, formato, agregación de APIs y checks repetitivos. La dirección estratégica, diseño de plantillas, seguridad de marca y QA aleatorio deben seguir en manos de operadores experimentados.
Ejecución avanzada: implementación de Model Context Protocol
A medida que la automatización madura, los workflows de SEO técnico van más allá de visual node builders. Model Context Protocol representa un cambio en cómo los sistemas de IA interactúan con herramientas externas, file systems y bases de datos.
Descomponer la arquitectura de Model Context Protocol
Model Context Protocol es un estándar abierto diseñado para permitir que asistentes de IA se conecten de forma segura a herramientas, aplicaciones y repositorios de datos.
Las plataformas tradicionales de automatización requieren que desarrolladores mapeen variables manualmente y configuren lógica. MCP expone herramientas aprobadas directamente a una interfaz de IA mediante servidores locales o remotos. Luego la IA puede ejecutar acciones complejas de varios pasos mediante lenguaje natural, manteniéndose dentro de límites de herramientas controlados.
Para SEO programático, esto importa porque la IA puede trabajar con contexto vivo:
- Datos de Search Console.
- Datos de Google Analytics 4.
- Bases de datos Supabase o PostgreSQL.
- Repositorios GitHub.
- Datasets de keywords.
- Guías editoriales internas.
- Exports de crawl e indexación.

Aplicaciones estratégicas de MCP en automatización SEO técnica
Los conectores MCP custom pueden acelerar análisis programático, generación de contenido y auditoría.
Casos de uso clave incluyen:
- Análisis competitivo autónomo de gaps: Un servidor MCP conectado a proveedores de datos SEO puede permitir que un analista pida a la IA identificar competidores principales, overlap de keywords, gaps de backlinks y deficiencias semánticas.
- Monitoreo de rendimiento y detección de decay: Un conector MCP para Google Search Console puede ayudar a diagnosticar páginas programáticas con caídas de impresiones, encontrar páginas en posiciones 8 a 15 y sugerir mejoras en secciones de respuesta o estructura de headings.
- Auditorías SEO técnicas a escala programática: Grandes lotes de URLs generadas pueden revisarse por estado de indexación, errores de crawl, problemas de renderizado o gaps de schema.
- Integración de base de datos para generación de contenido más segura: Un agente de IA conectado a Supabase puede revisar keywords objetivo existentes, prevenir cannibalization, leer reglas editoriales y generar borradores conformes basados en datos aprobados.
| Conector de servidor MCP | Capacidad principal de automatización SEO |
|---|---|
| Conector Google Search Console | Extrae estado de indexación en bulk, identifica ranking decay y analiza rendimiento de consultas para páginas en posiciones 8-15. |
| Conector Google Analytics 4 | Extrae tráfico, engagement y datos de sesión para medir ROI de páginas programáticas. |
| Conector Supabase o PostgreSQL | Consulta URLs y focus keywords existentes para reducir index bloat y cannibalization. |
| Conector GitHub o Git | Empuja páginas generadas al repositorio y activa despliegue. |
| Conector Google Ads o Meta Ads | Extrae CPC y datos de conversión para calcular viabilidad comercial de nuevos clusters de páginas. |
El despliegue estratégico de servidores MCP transforma un asistente de IA de una interfaz pasiva de chat a un operador técnico activo. Las organizaciones que necesitan conectar sistemas de IA a datos protegidos suelen necesitar integración Model Context Protocol para OAuth, gestión de tokens, límites de permisos y despliegue en producción.
Estructurar output para máquinas y usuarios humanos
Incluso cuando la fuente de datos es fuerte y la automatización es inteligente, el renderizado final de la página determina si buscadores y sistemas de IA pueden entenderla.
Entrega HTML limpia y accesibilidad de crawlers
El texto principal debe estar disponible inmediatamente en HTML plano. Información esencial, afirmaciones factuales y datos locales no deben esconderse dentro de accordions, tabs, sliders o componentes client-rendered solo con JavaScript que requieren interacción antes de que el contenido exista en el DOM.
Para SEO programático, la arquitectura debe priorizar static site generation o server-side rendering. El HTML inicial entregado al crawler debe contener el contenido principal, contexto local, entidades objetivo, FAQs, schema y ruta de conversión.
Esta es una razón por la que Astro puede encajar bien en sitios orientados a SEO: el contenido puede renderizarse como HTML estático y seguir permitiendo islas interactivas donde tienen sentido.
Sintetizar schema markup y datos estructurados
Schema markup es una capa de comunicación directa entre un sitio programático y sistemas de máquinas. Define relaciones de entidades, autoría, límites de contenido y propósito de página.
Tipos importantes de schema incluyen:
- Organization y Person schema: Mapean las entidades de marca y autor, apoyando señales E-E-A-T.
- FAQPage schema: Ayuda a IA y búsqueda a extraer bloques discretos de pregunta-respuesta.
- Article y WebPage schema: Definen el rol de la página en la arquitectura del sitio.
- ImageObject y VideoObject schema: Añaden contexto, captions, alt text e información de licencia para assets multimedia.
- LocalBusiness schema: Útil cuando páginas programáticas apoyan descubrimiento de servicios por ubicación.
Schema no debe compensar contenido visible débil. Debe aclarar contenido fuerte que los usuarios ya pueden leer.
La aparición e implementación de llms.txt
A medida que evolucionan los protocolos de ingestión por IA, los sitios empiezan a usar llms.txt en la raíz del dominio. Similar en ubicación a robots.txt, un archivo llms.txt normalmente se escribe en Markdown y da a modelos de IA un mapa conciso del alcance factual del sitio, enlaces canónicos de documentación, definiciones de entidades y recursos de alto valor.
Para un sitio de SEO programático, llms.txt puede ayudar a explicar:
- Servicios y expertise principales del sitio.
- URLs canónicas de servicios y ubicaciones.
- Documentación importante o páginas de casos de estudio.
- Citas preferidas y páginas fuente.
- Páginas que resumen la entidad del negocio y el autor.
No reemplaza HTML rastreable, schema ni enlaces internos. Es una guía adicional legible por máquinas que puede apoyar descubrimiento por IA.
Errores operativos comunes y consideraciones estratégicas
El SEO programático introduce riesgo cuando se despliega sin gobernanza. Los problemas más grandes rara vez son causados por la automatización misma. Vienen de datos débiles, umbrales débiles, revisión débil y arquitectura débil.
Index bloat y agotamiento de crawl budget
Generar miles de URLs sin suficientes datos diferenciadores crea index bloat. Los buscadores pueden identificar el dominio como fuente de duplicación de bajo valor y reducir atención de crawl en todo el sitio.
La generación programática debe gobernarse mediante mapeo de intención y umbrales estrictos de validación de datos. Si una página no tiene suficientes datos únicos para merecer indexación, no debería publicarse como URL indexable.
Cannibalization semántica de keywords
Sin una base de datos central que rastree focus keywords, intención de URL y cobertura de contenido existente, los workflows automatizados pueden generar páginas superpuestas. Esas páginas compiten entre sí en resultados de búsqueda y diluyen autoridad.
Todo sistema programático debe mantener una fuente de verdad para:
- Intención principal de consulta.
- Slug URL.
- Dueño de página canónica.
- Servicios relacionados.
- Ubicaciones relacionadas.
- Fecha de publicación.
- Fecha de última actualización.
- Estado de indexación.
Alucinaciones algorítmicas e integridad de datos
Los LLMs no deben generar afirmaciones factuales sin un feed de datos que los limite. Un modelo al que se le pide “write a local SEO page for Miami construction permits” puede inventar afirmaciones salvo que esté grounded en datos reales de permisos.
La arquitectura más segura es retrieval-first:
- Obtener los datos fuente.
- Normalizar los campos.
- Calcular los outputs factuales.
- Pasar solo esos hechos al modelo.
- Pedir al modelo que sintetice, formatee y explique.
- Validar el resultado contra los datos fuente.
Descuidar la supervisión human-in-the-loop
La autonomía completa es una suposición peligrosa en SEO enterprise. Los agentes y workflows de IA deben actuar como multiplicadores de fuerza para investigación de datos, formato HTML, agregación API y quality checks.
La arquitectura de plantillas, posicionamiento de marca, sensibilidad legal, reglas de aprobación final y auditorías aleatorias de calidad deben permanecer bajo control humano.
Matriz de decisión: cuándo construir, automatizar u optimizar
Los líderes de negocio deben evaluar madurez digital, infraestructura existente y activos de datos antes de invertir en SEO programático avanzado.
Cuándo construir
Si la organización carece de una base digital robusta, prioriza primero la arquitectura del sitio. Startups y negocios locales necesitan infraestructura rápida, segura y rastreable antes de intentar escala programática.
En esta fase, la prioridad es desarrollo full-stack, decisiones CMS, arquitectura estática o server-rendered, arquitectura de información limpia y rutas de conversión.
Cuándo automatizar
Si la organización ya tiene datasets únicos y un sitio funcional, el foco puede moverse a escalar. Ejemplos incluyen listings inmobiliarios propietarios, analytics de CRM, logs de servicios, inventarios de keywords o datos operativos específicos por ubicación.
Aquí es donde workflows n8n, agentes de IA, integraciones API y sistemas MCP pueden reducir customer acquisition cost capturando intención long-tail sin construir una operación grande de contenido manual.
Cuándo optimizar
Si un despliegue programático existente o una gran biblioteca de contenido está perdiendo tráfico después de updates algorítmicos o cambios de AI Overview, la estrategia debe pivotar hacia auditorías SEO técnicas y GEO.
Eso significa reestructuración de schema, aclaración de entidades, content pruning, decisiones noindex, diagnósticos de crawl, reparación de enlazado interno e integración de datos de rendimiento desde Search Console o herramientas de analytics.
| Estado organizacional | Objetivo principal | Acción estratégica recomendada |
|---|---|---|
| Sitio legacy, tiempos de carga lentos, HTML fundacional débil | Establecer una base segura y rastreable | Construir: enfocarse en desarrollo full-stack y migración CMS. |
| Sitio funcional, acceso a datos propietarios o locales, alto costo manual de contenido | Escalar alcance orgánico y reducir customer acquisition cost | Automatizar: desplegar workflows n8n, APIs y agentes de IA. |
| Gran biblioteca de contenido, caída de tráfico, pérdida de visibilidad frente a AI Overviews | Recuperar tráfico perdido y adaptarse a buscadores generativos | Optimizar: implementar GEO, schema markup y llms.txt. |
Preguntas frecuentes
¿El contenido generado con IA es penalizado automáticamente por Google?
Los algoritmos y guías actuales de búsqueda no prohíben ni penalizan inherentemente el contenido generado con IA. En cambio, los algoritmos penalizan contenido que demuestra falta de originalidad, expertise y valor añadido para el usuario.
Si la inteligencia artificial se usa para formatear, estructurar y sintetizar datasets únicos en un formato útil y legible, el output puede alinearse con objetivos people-first content.
¿Cuál es la diferencia fundamental entre SEO y GEO?
Search Engine Optimization tradicional se enfoca en optimizar activos digitales para rankear más alto en resultados orgánicos mediante crawlability, relevancia, enlaces internos, backlinks y autoridad.
Generative Engine Optimization es la disciplina moderna de estructurar y formatear contenido para que answer engines con IA, como ChatGPT, Perplexity y Google AI Overviews, puedan extraer, confiar y citar la información en respuestas resumidas.
¿En qué se diferencia Model Context Protocol de herramientas como Zapier o n8n?
Las plataformas tradicionales de automatización requieren que los desarrolladores mapeen variables manualmente y conecten nodos visuales de lógica para crear automatizaciones estructuradas.
Model Context Protocol ofrece una capa de conexión estandarizada que permite a un modelo de IA interactuar con una API, base de datos, repositorio o herramienta externa mediante capacidades aprobadas de servidor. Esto permite que la IA planifique y ejecute acciones multi-step en lenguaje natural mientras permanece dentro de límites definidos de permisos.
¿Cómo evitan los arquitectos técnicos penalizaciones por thin content en una campaña de SEO programático?
El thin content se evita inyectando datos únicos y verificables en cada URL programática.
Eso puede incluir APIs municipales de datos abiertos, datos propietarios de CRM, reseñas locales verificadas, registros históricos de servicios, contexto geoespacial, cálculos de precios y freshness loops que actualizan la página cuando cambian los datos subyacentes.
¿Qué es exactamente un freshness loop en SEO programático?
Un freshness loop es un proceso técnico automatizado que revisa continuamente fuentes de datos internas o externas en busca de updates.
Cuando se detectan nuevos datos, el workflow recalcula estadísticas de página, actualiza plantillas o módulos de contenido relevantes, valida el resultado y publica los cambios. Esto mantiene el contenido actualizado, factual y más útil para crawlers y usuarios.
Conclusión y siguientes pasos estratégicos
La era de escalar tráfico orgánico publicando masivamente páginas programáticas genéricas y templadas terminó. AI Overviews, motores de respuesta y Generative Engine Optimization exigen un enfoque más sofisticado para crecimiento digital.
El éxito sostenido requiere datasets únicos, workflows complejos de automatización, herramientas como n8n y Model Context Protocol, y estándares rigurosos de SEO técnico y datos estructurados.
Ejecutar esta arquitectura no es solo un esfuerzo de marketing. Es un esfuerzo de ingeniería de software y orquestación de datos. Los negocios que transforman sitios estáticos en hubs de datos estructurados, autoritativos y dinámicamente actualizados pueden ganar una mayor cuota de visibilidad en el ecosistema de AI search. Las organizaciones que dependen de keyword swapping obsoleto y generación de texto de bajo esfuerzo serán más fáciles de ignorar para los algoritmos.
Construir, escalar y mantener estos sistemas requiere un enfoque multidisciplinario en estrategia digital, desarrollo de software, análisis de datos e implementación de IA.
Agenda una llamada de descubrimiento para explorar cómo automatización IA personalizada y SEO técnico avanzado pueden apoyar crecimiento sostenible y escalable para la infraestructura digital de tu organización.
Obras citadas
- Google Search’s guidance on using generative AI content on your website
- Google AI Search Guidelines (2025): What They Mean for SEO
- Google AI Overviews: What’s Changing for SEO & SEA in 2025
- Generative engine optimization (GEO): How to win AI mentions
- Programmatic SEO: Build High-Intent Pages Without Thin Content
- Generative Engine Optimization (GEO) in 2025: Get Cited by AI
- 10-step framework for generative engine optimization
- I built a full SEO automation pipeline in n8n that updates my website daily
- City of Miami Developer Portal
- City of Orlando Open Data Portal
- Data Explorer - City of Miami
- The Complete Guide to SEO Automation with n8n Using AI Agents
- How I used n8n for programmatic SEO
- Claude MCPs and Prompts for SEO Blog Automation
- AI-powered product research and SEO content automation
- AI agents in SEO: A practical workflow walkthrough
- AI Search Content Optimization: The Complete Guide
- GEO: The Complete Guide to AI-First Content Optimization 2025
- SEO Automations are 10X Easier With Claude MCP
- What is Model Context Protocol?
- Seamless Frase Integration with Claude Code, Cursor, and More
- Top SEO MCP Servers in 2026: Tools and Use Cases
- Claude MCP Connector Guide: Setup, Auth and Top Use Cases 2026
- Google Search’s guidance about AI-generated content