
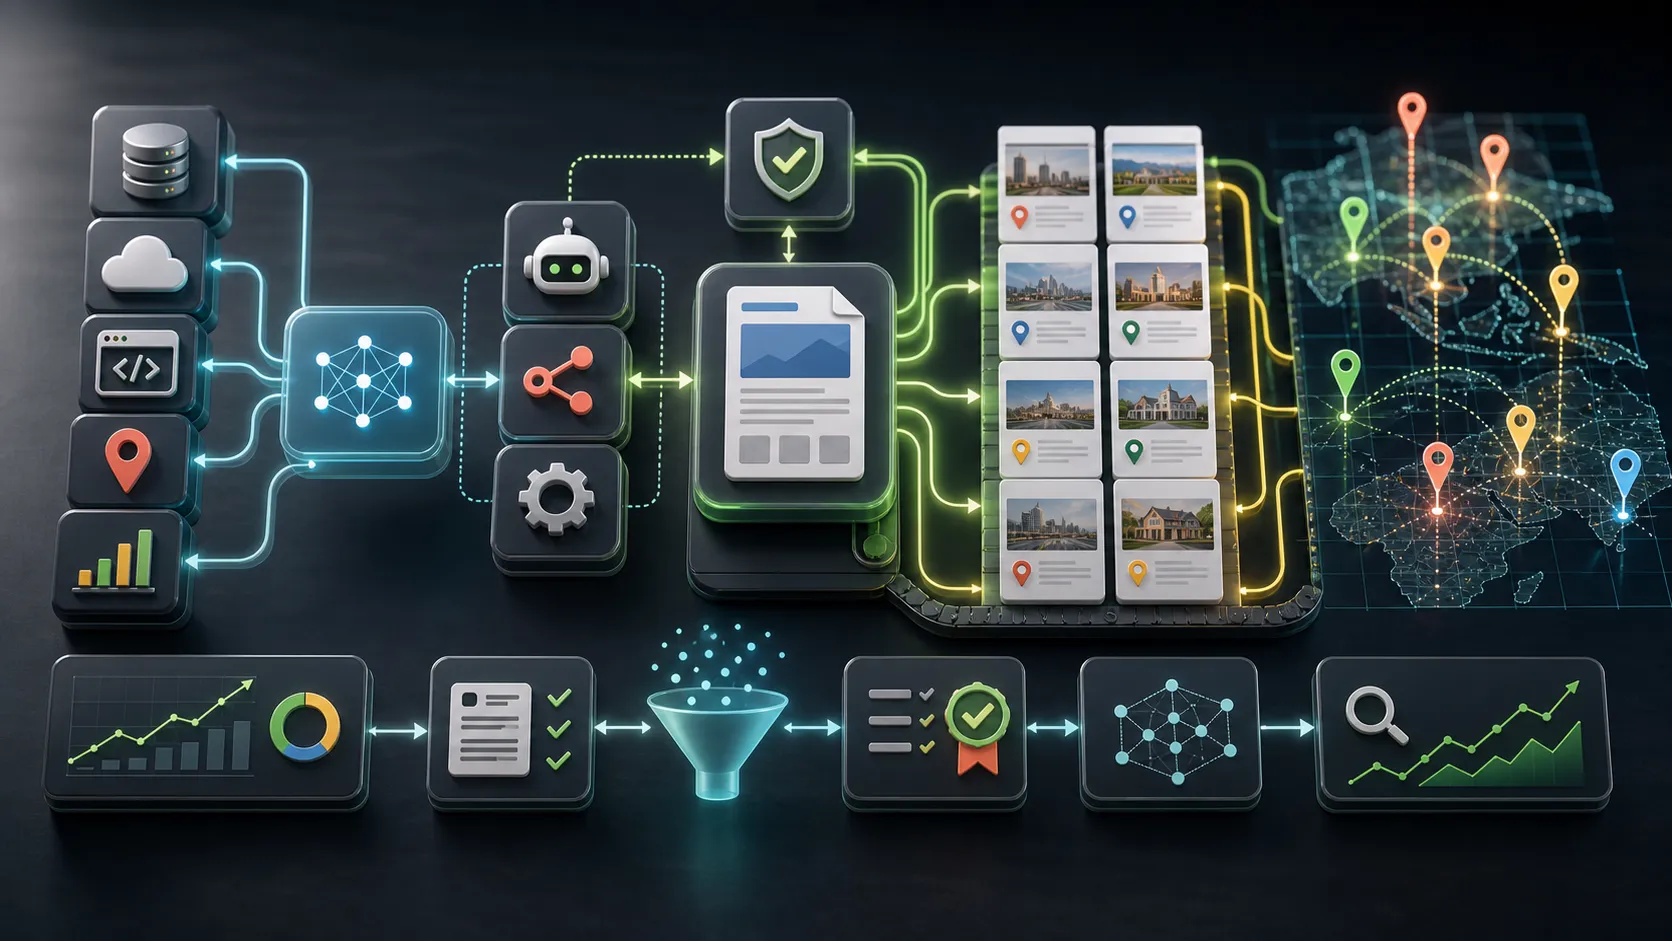
Il SEO programmatico è cambiato. Il vecchio modello era semplice: prendere un template di landing page, sostituire la variabile servizio, città, categoria o prodotto, e pubblicare migliaia di URL quasi identiche. Quel metodo un tempo catturava traffico long-tail. Ora è una responsabilità rischiosa.
I sistemi di ricerca moderni valutano profondità semantica, originalità, esperienza e utilità. Google AI Overviews, answer engine come Perplexity e ChatGPT, e crawler di ricerca tradizionali premiano contenuti che possono essere parsati, fidati, citati e collegati a dati reali. Questo significa che il SEO programmatico non è più principalmente un problema di produzione contenuti. È un problema di orchestrazione dati.
La qualità su scala richiede ora un’architettura tecnica: fonti dati strutturate, template ripetibili, workflow di automazione AI, sistemi SEO programmatici, SEO tecnico e GEO, internal linking, schema, freshness loop e controllo qualità umano.
Questo articolo spiega come costruire SEO programmatico senza pagine thin usando agenti AI, workflow n8n, integrazioni Model Context Protocol, dati geospaziali localizzati e pagine statiche o server-rendered crawlable.
Introduzione: il cambio architetturale nella discovery search
La search engine optimization si è spostata dal matching euristico di keyword verso sintesi semantica guidata da Large Language Models. Storicamente, il SEO programmatico prevedeva la generazione massiva di landing page sostituendo keyword localizzate o variabili stringa generiche dentro un template HTML statico. Anche se questo approccio catturava traffico organico long-tail, gli algoritmi moderni e gli answer engine guidati da AI hanno reso obsoleto il templating a basso sforzo.
Le linee guida attuali di qualità search puntano pagine in cui il contenuto principale mostra poco sforzo, poca originalità e poco valore aggiunto. In pratica, una pagina che cambia solo nome città, etichetta settore o categoria prodotto non è un asset SEO duraturo. È un rischio di thin content.
I motori moderni di discovery usano sistemi di neural search e modelli linguistici per valutare profondità semantica, esperienza diretta e utilità reale. Google AI Overviews e l’adozione di answer engine hanno introdotto una disciplina operativa più nuova: Generative Engine Optimization, o GEO.
Dentro questo framework, il SEO programmatico funziona ancora, ma i requisiti di base sono molto più alti. Scalare visibilità organica ora richiede pipeline dati uniche, architettura tecnica strutturata e workflow AI che mantengono qualità su molte URL generate.
Per imprese digitali e organizzazioni di servizi che cercano crescita organica scalabile, l’obiettivo non è più la generazione di contenuti in sé. L’obiettivo è l’orchestrazione dati. Strategie moderne sintetizzano automazione AI, integrazioni database uniche ed esecuzione programmatica per produrre asset ad alto valore, guidati dall’intento e scalabili.
Le meccaniche della Generative Engine Optimization
Per progettare pagine programmatiche di alta qualità, gli architetti devono prima capire come i moderni motori di ricerca generativa ingeriscono, processano e citano contenuti.
Generative Engine Optimization è la disciplina tecnica ed editoriale che struttura asset digitali affinché piattaforme AI possano scoprire, ingerire, fidarsi e citare i contenuti quando sintetizzano risposte a query complesse.
Transizione da keyword density ad autorità di citazione
Gli algoritmi di ricerca tradizionali dipendevano molto da keyword targeting, autorità dei link interni e profili backlink esterni. Gli answer engine generativi operano di più su estrazione semantica di entità e autorità di citazione.
I motori generativi assemblano risposte attraverso una pipeline multi-step:
- Scoprono pagine tramite crawler, feed strutturati, sitemap o protocolli come IndexNow.
- Parsano HTML grezzo e schema JSON-LD per segnali semantici.
- Recuperano chunk di testo isolati rilevanti per il prompt.
- Generano una risposta sintetizzata con citazioni al materiale fonte.
Questo cambia il target di ottimizzazione. Invece di puntare solo a frasi keyword rigide, il contenuto programmatico deve mappare intenzione conversazionale e fornire blocchi fattuali estraibili. Gli utenti interagiscono con motori AI tramite prompt complessi e multi-parte invece di brevi frammenti keyword.
Per diventare una fonte citata, il contenuto programmatico ha bisogno di chiarezza modulare. Blocchi strutturati, step ordinati, affermazioni concise, tabelle e risposte dirette rendono più facile per i sistemi AI estrarre il passaggio corretto.

| Metrica operativa | Search Engine Optimization tradizionale | Generative Engine Optimization |
|---|---|---|
| Segnale ranking primario | Posizione organica | Visibility score e frequenza citazioni |
| Meccanismo trust primario | Domain rating e backlink esterni | Autorità di citazione e riconoscimento entità |
| Input utente standard | Keyword frammentate, come “Miami plumber” | Prompt conversazionali e intenzione complessa |
| Benchmark core di successo | Volume traffico totale e click-through | Citazioni AI, share of voice e menzioni brand |
| Formato contenuto ottimale | Narrative long-form con keyword placement | Claim estraibili, blocchi strutturati e risposte dirette |
| Focus architetturale | Internal linking e gerarchie URL | Schema markup, integrazioni API e llms.txt |
Analisi dei criteri di selezione AI Overview e metriche performance
La ricerca empirica SEO ha suggerito che le fonti citate dentro Google AI Overviews spesso provengono da pagine già ben posizionate nella ricerca organica tradizionale. Gli AI Overviews sono anche attivati dinamicamente in base alla classificazione della query. Appaiono più spesso per intenti informativi, domande complesse multifaccettate e query semantiche long-tail. Appaiono meno spesso per alcune query altamente commerciali o transazionali.
Gli AI Overviews hanno anche cambiato il comportamento di clic. Alcuni studi di settore hanno riportato click-through rate più bassi per listing organici standard quando è presente un AI Overview, mentre le fonti citate possono ricevere maggiore attenzione di clic rispetto ai competitor non citati.
Queste cifre variano per tipo di query, layout SERP, intento commerciale e settore. Il punto strategico è più stabile di qualsiasi benchmark: una pagina SEO programmatica non dovrebbe inseguire solo un ranking da link blu. Dovrebbe funzionare come repository dati strutturato e autorevole che i sistemi AI possono usare per estrazione di claim.
Questo richiede precisione tecnica. Struttura DOM, schema, link interni, blocchi fattuali e architettura database devono supportare sia parsing macchina sia utilità umana.
Anatomia di architetture programmatiche di alta qualità
Per evitare thin content, l’infrastruttura programmatica deve offrire valore unico su ogni URL generata. La soluzione è smettere di riscrivere testo e iniziare ad arricchire dati.

Sfruttare fonti dati proprietarie e uniche
Il layer fondamentale della qualità su scala è dato proprietario o iper-specifico. Invece di deployare un template con copy marketing generico e nomi città sostituiti, una pagina programmatica forte diventa un’interfaccia per dati localizzati, recensioni cliente verificate, variabili ambientali contestuali, dataset visuali dinamici o business intelligence interna.
Fonti utili possono includere:
- Cataloghi prodotto con specifiche e disponibilità.
- Record di servizi locali da un CRM.
- Recensioni verificate per servizio e località.
- API open data municipali.
- Dataset geospaziali.
- Matrici di confronto.
- Dati API partner.
- Tassonomie di settore o categoria.
Per esempio, un’architettura programmatica sofisticata potrebbe aggregare codici edilizi locali, calcolare costi medi di servizio da dati CRM storici, generare case study specifici per quartiere e integrare pattern meteo che creano domanda per servizi di manutenzione.
Questo approccio data-first soddisfa il requisito centrale di contenuto unico e non commodity. La pagina non è più un template di frasi. Diventa una sintesi utile di informazioni difficili da trovare altrove.
Progettare e implementare il freshness loop
Le pagine programmatiche statiche decadono quando i dati sottostanti diventano obsoleti. Per mantenere rilevanza, l’architettura dovrebbe includere un freshness loop.
Un freshness loop è una pipeline ciclica automatizzata in cui fonti dati esterne e interne vengono controllate regolarmente per aggiornamenti. Quando il dato cambia, i fatti, calcoli, riassunti e moduli pagina risultanti vengono aggiornati senza una riscrittura completamente manuale.
Un workflow pratico può apparire così:
- Un nuovo progetto, recensione, permesso, listing o record servizio appare in un database.
- Il workflow ricalcola statistiche locali aggregate.
- Un agente AI riassume solo i dati forniti.
- Il contenuto generato viene controllato contro regole qualità.
- Markdown, HTML, riga database o voce CMS aggiornata viene pubblicata.
- Sitemap o segnale di indicizzazione viene aggiornato.
Questo mantiene il contenuto corrente, migliora fiducia e dà a utenti e crawler un motivo per rivisitare la pagina.
Sistematizzare trust signal ed E-E-A-T su scala
Experience, Expertise, Authoritativeness e Trustworthiness sono pilastri critici di valutazione nella ricerca moderna. Per scalare E-E-A-T in un deployment programmatico, segnali trust espliciti dovrebbero essere integrati nei template core.
Segnali trust chiave includono:
- Attribuzione autoriale dinamica: Collegare asset programmatici a subject matter expert verificati e supportarli con schema Person e Organization.
- Trasparenza citazioni: Mostrare link visibili agli endpoint API, portali dati governativi locali o fonti interne dietro claim numerici.
- Aggregazione e verifica recensioni: Recuperare recensioni verificate iperlocali e specifiche per servizio per dimostrare esperienza cliente reale.
- Date aggiornamento chiare: Mostrare quando la pagina è stata revisionata o quando il dato sottostante è stato aggiornato.
- Percorsi conversione specifici: Dare agli utenti uno step successivo pratico invece di lasciarli su una pagina informativa passiva.
Localizzazione data-driven: usare API open data in Florida
Per organizzazioni di servizi, team real estate e aziende locali, dati civici e geospaziali possono arricchire pagine programmatiche con contesto locale fattuale.
Invece di scrivere pagine città generiche, un business può interrogare portali open data municipali e costruire landing page che rispondono a domande locali specifiche con evidenza.
Integrazione dei portali open data di Miami e Orlando
I comuni della Florida offrono dataset pubblici utili per sviluppatori, ricercatori e operatori business. Il City of Miami Developer Portal offre accesso a dataset civici tramite strategie REST API, Esri Geoservices e formati GeoJSON. Il portale City of Orlando Open Data offre dataset come report permessi, inventari lotti vacanti, parametri zoning e dati sicurezza pubblica.
Per una strategia SEO in Florida, questo conta perché una pagina locale può essere costruita da segnali locali reali invece di linguaggio geografico thin. Una pagina di SEO tecnico a Miami, per esempio, può diventare più forte quando collega intento locale, contesto servizio e condizioni operative fattuali.
| Dataset municipale Florida | Formato API disponibile | Applicazione SEO programmatica |
|---|---|---|
| Miami 311 Service Requests | API REST geospaziale | Identificare problemi infrastrutturali iperlocali e attivare pagine per servizi di restoration, plumbing, roofing o disaster recovery basate su cluster di incidenti. |
| Miami Building Permits | GeoJSON o REST | Aggregare timeline permessi commerciali e costi costruzione per guide real estate, construction e investment. |
| Miami 21 Zoning Data | ArcGIS Geoservice | Creare guide localizzate di proprietà commerciali che si aggiornano quando cambiano zone transect o contesto zoning. |
| Orlando Permitting Reports | Socrata Open Data API | Identificare zone emergenti di sviluppo e generare pagine servizi B2B per nuova costruzione commerciale. |
| Orlando Vacant Lots Inventory | REST API | Supportare pagine per sviluppatori, landscapers, società di property maintenance e operatori real estate. |
Architettura caso studio: commercial real estate e construction
Considera una società di costruzione o consulenza commercial real estate operante in South Florida. L’organizzazione può usare dati dei building permits di Miami, che includono attributi come date applicazione, stato elaborazione, costi stimati e timeline di revisione.
Un’architettura SEO programmatica avanzata potrebbe interrogare questo dataset settimanalmente per generare e aggiornare insight specifici per quartiere. Le pagine risultanti potrebbero includere:
- Dati aggregati sui tempi medi per permessi commerciali in specifiche transect zone di Miami.
- Cross-reference ai dati zoning Miami 21.
- Mappe interattive che mostrano sviluppo recente dentro un raggio definito.
- Riassunti generati con AI sulle tendenze construction basati solo su dati grezzi di costo e timeline provenienti dall’API.
Questo crea una pagina più forte di un articolo generico “commercial real estate Miami” perché risponde a una vera domanda locale con dati correnti.
Architettura caso studio: disaster recovery e property maintenance
I business di servizi focalizzati su roofing, plumbing o property restoration possono applicare lo stesso pattern ai dati Miami 311 service request.
Filtrando dati geospaziali per ZIP code o coordinate specifiche, un sistema di analisi automatizzato può identificare quartieri con report concentrati di flooding, alberi caduti, guasti infrastrutturali o problemi correlati.
Le landing page programmatiche per quei quartieri possono citare dati locali empirici e offrire servizi che rispondono direttamente a bisogni comunitari verificati. In Central Florida, le aziende possono usare inventario lotti vacanti Orlando o report permessi per identificare zone di sviluppo e creare pagine utili per sviluppatori, team maintenance e provider B2B.
Questo approccio produce pagine con densità fattuale e originalità locale. È la differenza tra local SEO utile e doorway pages a basso valore.
Automatizzare la pipeline di produzione con n8n e agenti AI
Eseguire integrazione dati, calcolo statistico e generazione contenuti su molte URL richiede infrastruttura di orchestrazione. n8n è un buon fit per operazioni SEO complesse e data-driven perché supporta logica custom, JavaScript, self-hosting, integrazioni API e design workflow flessibile.
A differenza di strumenti SaaS rigidi, n8n dà ai team tecnici controllo granulare su logica workflow, error handling e custodia dati. Questo conta quando il sistema SEO programmatico deve gestire dati CRM proprietari, credenziali API locali, dataset search e credenziali di publishing.
Progettare l’architettura tecnica del workflow
Una pipeline SEO programmatica di alta qualità in n8n usa tipicamente più agenti AI e step di validazione in sequenza.
- Trigger execution e acquisizione dati: Il workflow parte da uno schedule cron o webhook. Un nodo HTTP Request recupera dati da una API target, come endpoint geoservice Miami, export Google Ads keyword, export Search Console o CRM proprietario.
- Analisi agentic dei dati e identificazione gap: Il JSON grezzo viene parsato e passato a un modello AI tramite un’integrazione come LangChain. L’agente è vincolato da un system prompt rigido e deve identificare gap di intento, pattern competitor o moduli pagina utili dai dati forniti.
- Sintesi contenuto ed enforcement formato: Un secondo nodo AI crea il contenuto pagina in sezioni modulari e answer-focused con heading H2 e H3 chiari. L’output deve restare visibile in HTML plain o Markdown, non nascosto in UI client-only.
- Generazione metadata e implementazione schema: Un altro nodo genera title tag, slug, meta description e JSON-LD come FAQPage, Article, Organization o LocalBusiness schema.
- Quality assurance e human-in-the-loop routing: Prima della pubblicazione, un sub-workflow di validazione controlla cannibalization, presenza schema, riferimenti fonte, campi obbligatori, word count, duplicazione e rischio hallucination. Le bozze più rischiose vengono instradate a un revisore umano in Slack, Teams o coda CMS.
- Pubblicazione e indicizzazione algoritmica: Una volta validato, il workflow pubblica su CMS, repository static site o database. Può anche aggiornare XML sitemap o inviare un segnale di indicizzazione.
| Categoria nodo core n8n | Funzione primaria nel SEO programmatico |
|---|---|
| Nodi Webhook e Cron | Avviano il freshness loop basato su intervalli temporali, cambi database o eventi esterni. |
| Nodi HTTP Request | Recuperano dati geospaziali grezzi da API open data Florida o strumenti SEO esterni. |
| Nodi LangChain e AI Agent | Processano dati, eseguono SERP gap analysis e sintetizzano HTML o Markdown modulare. |
| Nodi PostgreSQL e Supabase | Interrogano il database interno per prevenire keyword cannibalization e loggare URL pubblicate. |
| Nodi comunicazione | Instradano asset generati a editor umani per QA finale e approvazione. |
Questa infrastruttura riduce l’overhead manuale di grandi operazioni contenuto e aiuta a catturare intento long-tail senza dipendere da un team contenuti tradizionale ad alto volume. Per team che hanno bisogno di collegare automazione sicura, API key ed error handling, automazione workflow AI diventa parte dell’architettura SEO invece di essere uno strumento operativo separato.
Mitigare gli svantaggi delle piattaforme di automazione
Piattaforme di automazione e agenti AI creano leva, ma introducono anche rischio operativo. Community node possono rompersi dopo aggiornamenti piattaforma. Grandi job di analisi possono superare context window del modello. Prompt vaghi possono produrre consigli generici invece di output utile.
Il sistema non dovrebbe mai affidarsi al language model per inventare fatti dai dati di training. Usa il modello come motore di ragionamento, categorizzazione e formattazione. Vincolalo ai dati civici, proprietari o derivati da API forniti nel workflow.
La supervisione umana resta non negoziabile. Gli agenti AI dovrebbero gestire ricerca, formattazione, aggregazione API e check ripetitivi. Direzione strategica, design template, brand safety e quality assurance randomizzata devono restare responsabilità di operatori esperti.
Esecuzione avanzata: implementare il Model Context Protocol
Man mano che l’automazione matura, i workflow SEO tecnici si stanno spostando oltre i visual node builder. Model Context Protocol rappresenta un cambio nel modo in cui sistemi AI interagiscono con strumenti esterni, file system e database.
Scomporre l’architettura Model Context Protocol
Model Context Protocol è uno standard aperto progettato per permettere ad assistenti AI di collegarsi in sicurezza a strumenti, applicazioni e repository dati.
Le piattaforme di automazione tradizionali richiedono agli sviluppatori di mappare manualmente variabili e configurare logica. MCP espone strumenti approvati direttamente a un’interfaccia AI tramite server locali o remoti. L’AI può quindi eseguire azioni complesse e multi-step tramite linguaggio naturale restando dentro tool boundary controllati.
Per il SEO programmatico, questo conta perché l’AI può lavorare con contesto live:
- Dati Search Console.
- Dati Google Analytics 4.
- Database Supabase o PostgreSQL.
- Repository GitHub.
- Dataset keyword.
- Linee guida editoriali interne.
- Export crawl e indexation.

Applicazioni strategiche di MCP nell’automazione SEO tecnica
Connettori MCP custom possono accelerare analisi programmatica, generazione contenuto e auditing.
Casi d’uso chiave includono:
- Analisi competitiva autonoma dei gap: Un server MCP collegato a provider dati SEO può consentire a un analista di chiedere all’AI di identificare competitor principali, overlap keyword, gap backlink e carenze semantiche.
- Monitoraggio performance e decay detection: Un connettore MCP per Google Search Console può aiutare a diagnosticare pagine programmatiche con cali di impression, trovare pagine in posizioni 8-15 e suggerire miglioramenti a sezioni risposta o struttura heading.
- Audit SEO tecnico su scala programmatica: Grandi batch di URL generate possono essere controllati per stato indicizzazione, crawl error, problemi rendering o gap schema.
- Integrazione database per generazione contenuti più sicura: Un agente AI collegato a Supabase può controllare focus keyword esistenti, prevenire cannibalization, leggere regole editoriali e generare bozze conformi basate su dati approvati.
| Connettore server MCP | Capacità core di automazione SEO |
|---|---|
| Connettore Google Search Console | Estrae stato indicizzazione bulk, identifica ranking decay e analizza performance query per pagine in posizioni 8-15. |
| Connettore Google Analytics 4 | Recupera traffico, engagement e dati sessione per misurare ROI delle pagine programmatiche. |
| Connettore Supabase o PostgreSQL | Interroga URL e focus keyword esistenti per ridurre index bloat e cannibalization. |
| Connettore GitHub o Git | Pusha pagine generate al repository e attiva deploy. |
| Connettore Google Ads o Meta Ads | Recupera dati CPC e conversione per calcolare la viabilità commerciale di nuovi cluster pagina. |
Il deployment strategico di server MCP trasforma un assistente AI da interfaccia chat passiva a operatore tecnico attivo. Le organizzazioni che devono collegare sistemi AI a dati protetti spesso hanno bisogno di integrazione Model Context Protocol per OAuth, gestione token, permission boundary e deployment production.
Strutturare l’output per macchine e utenti umani
Anche quando la fonte dati è forte e l’automazione intelligente, il rendering finale della pagina determina se motori di ricerca e sistemi AI possono comprenderla.
Delivery HTML plain e accessibilità crawler
Il testo primario dovrebbe essere immediatamente disponibile in HTML plain. Informazioni essenziali, claim fattuali e dati locali non dovrebbero essere nascosti dentro accordion, tab, slider o componenti client-rendered solo JavaScript che richiedono interazione prima che il contenuto esista nel DOM.
Per SEO programmatico, l’architettura dovrebbe dare priorità a static site generation o server-side rendering. L’HTML iniziale consegnato al crawler dovrebbe contenere contenuto primario, contesto locale, entità target, FAQ, schema e percorso conversione.
Questo è uno dei motivi per cui Astro può essere un buon fit per siti focalizzati sulla SEO: il contenuto può essere renderizzato come HTML statico permettendo comunque isole interattive dove hanno senso.
Sintetizzare schema markup e dati strutturati
Lo schema markup è un layer di comunicazione diretto tra sito programmatico e sistemi macchina. Definisce relazioni tra entità, autorialità, confini del contenuto e scopo pagina.
Tipi schema importanti includono:
- Organization e Person schema: Mappano brand e autore, supportando segnali E-E-A-T.
- FAQPage schema: Aiuta AI e search a estrarre blocchi domanda-risposta discreti.
- Article e WebPage schema: Definiscono il ruolo della pagina nell’architettura sito.
- ImageObject e VideoObject schema: Aggiungono contesto, caption, alt text e licensing per asset media.
- LocalBusiness schema: Utile quando pagine programmatiche supportano discovery di servizi location-specific.
Lo schema non dovrebbe compensare contenuto visibile debole. Dovrebbe chiarire contenuto forte che gli utenti possono già leggere.
Emergenza e implementazione di llms.txt
Man mano che evolvono i protocolli di ingestione AI, i siti stanno iniziando a usare llms.txt alla root del dominio. Simile per posizione a robots.txt, un file llms.txt di solito è scritto in Markdown e dà ai modelli AI una mappa concisa dello scope fattuale del sito, link documentazione canonici, definizioni entità e risorse ad alto valore.
Per un sito SEO programmatico, llms.txt può aiutare a spiegare:
- Servizi core ed expertise del sito.
- URL canoniche di servizi e località.
- Documentazione importante o pagine case study.
- Citazioni preferite e pagine fonte.
- Pagine che riassumono entità business e autore.
Non sostituisce HTML crawlable, schema o internal link. È una guida aggiuntiva machine-readable che può supportare discovery AI.
Errori operativi comuni e considerazioni strategiche
Il SEO programmatico introduce rischio quando viene deployato senza governance. I problemi maggiori raramente sono causati dall’automazione stessa. Derivano da dati deboli, soglie deboli, revisione debole e architettura debole.
Index bloat e esaurimento crawl budget
Generare migliaia di URL senza abbastanza dati differenzianti crea index bloat. I motori di ricerca possono identificare il dominio come fonte di duplicazione a basso valore e ridurre l’attenzione crawler su tutto il sito.
La generazione programmatica dovrebbe essere governata da intent mapping e soglie rigide di validazione dati. Se una pagina non ha abbastanza dati unici da meritare indicizzazione, non dovrebbe essere pubblicata come URL indexable.
Cannibalizzazione semantica delle keyword
Senza un database centrale che traccia focus keyword, intento URL e copertura contenuti esistente, i workflow automatizzati possono generare pagine sovrapposte. Quelle pagine competono tra loro nei risultati di ricerca e diluiscono autorità.
Ogni sistema programmatico dovrebbe mantenere una source of truth per:
- Intento query primario.
- URL slug.
- Proprietario pagina canonica.
- Servizi correlati.
- Località correlate.
- Data pubblicazione.
- Ultima data refresh.
- Stato indicizzazione.
Allucinazioni algoritmiche e integrità dati
Gli LLM non dovrebbero generare affermazioni fattuali senza un data feed vincolante. Un modello a cui viene chiesto di “write a local SEO page for Miami construction permits” può inventare claim salvo che sia grounded in dati reali sui permessi.
L’architettura più sicura è retrieval-first:
- Recuperare i dati fonte.
- Normalizzare i campi.
- Calcolare output fattuali.
- Passare al modello solo quei fatti.
- Chiedere al modello di sintetizzare, formattare e spiegare.
- Validare il risultato contro i dati fonte.
Trascurare supervisione human-in-the-loop
La piena autonomia è un’assunzione pericolosa nella SEO enterprise. Agenti AI e workflow dovrebbero agire come moltiplicatori di forza per ricerca dati, formattazione HTML, aggregazione API e quality check.
Architettura template, brand positioning, sensibilità legale, regole di approvazione finale e audit qualità random dovrebbero restare sotto controllo umano.
Matrice decisionale: quando costruire, automatizzare o ottimizzare
I business leader dovrebbero valutare maturità digitale, infrastruttura esistente e asset dati prima di investire in SEO programmatico avanzato.
Quando costruire
Se l’organizzazione manca di una fondazione digitale robusta, priorità all’architettura sito. Startup e aziende locali hanno bisogno di infrastruttura veloce, sicura e crawlable prima di tentare scala programmatica.
In questa fase, la priorità è sviluppo full-stack, decisioni CMS, architettura statica o server-rendered, information architecture pulita e percorsi conversione.
Quando automatizzare
Se l’organizzazione ha già dataset unici e un sito funzionale, il focus può spostarsi sulla scala. Esempi includono listing real estate proprietari, analytics CRM, log servizi, inventari keyword o dati operativi location-specific.
Qui workflow n8n, agenti AI, integrazioni API e sistemi MCP possono ridurre customer acquisition cost catturando intento long-tail senza costruire una grande operazione contenuto manuale.
Quando ottimizzare
Se un deployment programmatico esistente o una grande libreria contenuti sta perdendo traffico dopo update algoritmici o cambiamenti AI Overview, la strategia dovrebbe passare ad audit SEO tecnici e GEO.
Questo significa ristrutturazione schema, chiarimento entità, content pruning, decisioni noindex, diagnostica crawl, riparazione internal linking e integrazione di dati performance da Search Console o strumenti analytics.
| Stato organizzazione | Obiettivo primario | Azione strategica consigliata |
|---|---|---|
| Sito legacy, load time lenti, HTML fondazionale scarso | Stabilire baseline sicura e crawlable | Costruire: focus su sviluppo full-stack e migrazione CMS. |
| Sito funzionale, accesso a dati proprietari o locali, costi manuali contenuto alti | Scalare reach organica e ridurre customer acquisition cost | Automatizzare: deployare workflow n8n, API e agenti AI. |
| Grande libreria contenuti, traffico in calo, perdita visibilità verso AI Overviews | Recuperare traffico perso e adattarsi ai motori generativi | Ottimizzare: implementare GEO, schema markup e llms.txt. |
Domande frequenti
Il contenuto generato con AI viene penalizzato automaticamente da Google?
Gli algoritmi e le linee guida attuali di ricerca non vietano né penalizzano intrinsecamente il contenuto generato con AI. Al contrario, gli algoritmi penalizzano contenuti che dimostrano mancanza di originalità, expertise e valore aggiunto per l’utente.
Se l’intelligenza artificiale viene usata per formattare, strutturare e sintetizzare dataset unici in un formato utile e leggibile, l’output può allinearsi agli obiettivi people-first content.
Qual è la differenza fondamentale tra SEO e GEO?
La Search Engine Optimization tradizionale si concentra sull’ottimizzazione di asset digitali per rankare più in alto nei risultati organici tramite crawlability, rilevanza, link interni, backlink e autorità.
La Generative Engine Optimization è la disciplina moderna di strutturare e formattare contenuto affinché answer engine AI, come ChatGPT, Perplexity e Google AI Overviews, possano estrarre, fidarsi e citare le informazioni in risposte sintetizzate.
In che modo Model Context Protocol differisce da strumenti come Zapier o n8n?
Le piattaforme tradizionali di automazione richiedono agli sviluppatori di mappare manualmente variabili e connettere nodi logici visuali per creare automazioni strutturate.
Model Context Protocol fornisce un layer di connessione standardizzato che permette a un modello AI di interfacciarsi con API, database, repository o strumenti esterni tramite capacità server approvate. Questo consente all’AI di pianificare ed eseguire azioni multi-step in linguaggio naturale restando dentro boundary di permessi definiti.
Come evitano gli architetti tecnici penalità thin content in una campagna SEO programmatica?
Il thin content si evita inserendo dati unici e verificabili in ogni URL programmatica.
Questo può includere API municipali open data, dati CRM proprietari, recensioni locali verificate, record storici di servizi, contesto geospaziale, calcoli pricing e freshness loop che aggiornano la pagina quando il dato sottostante cambia.
Che cos’è esattamente un freshness loop nel SEO programmatico?
Un freshness loop è un processo tecnico automatizzato che controlla continuamente fonti dati interne o esterne per aggiornamenti.
Quando vengono rilevati nuovi dati, il workflow ricalcola statistiche pagina, aggiorna template o moduli contenuto rilevanti, valida il risultato e pubblica le modifiche. Questo mantiene il contenuto corrente, accurato e più utile per crawler e utenti.
Conclusione e prossimi step strategici
L’era di scalare traffico organico pubblicando in massa pagine programmatiche generiche e templated si è chiusa. AI Overviews, answer engine e Generative Engine Optimization richiedono un approccio più sofisticato alla crescita digitale.
Il successo sostenuto richiede dataset unici, workflow di automazione complessi, strumenti come n8n e Model Context Protocol, e standard rigorosi di SEO tecnico e dati strutturati.
Eseguire questa architettura non è solo un’attività marketing. È lavoro di software engineering e orchestrazione dati. Le aziende che trasformano siti statici in hub dati strutturati, autorevoli e dinamicamente aggiornati possono ottenere una quota più forte di visibilità nell’ecosistema AI search. Le organizzazioni che dipendono da keyword swapping obsoleto e generazione testo a basso sforzo diventeranno più facili da ignorare per gli algoritmi.
Costruire, scalare e mantenere questi sistemi richiede un approccio multidisciplinare tra strategia digitale, sviluppo software, analisi dati e implementazione AI.
Prenota una discovery call per esplorare come automazione AI custom e SEO tecnico avanzato possono supportare crescita sostenibile e scalabile per l’infrastruttura digitale della tua organizzazione.
Opere citate
- Google Search’s guidance on using generative AI content on your website
- Google AI Search Guidelines (2025): What They Mean for SEO
- Google AI Overviews: What’s Changing for SEO & SEA in 2025
- Generative engine optimization (GEO): How to win AI mentions
- Programmatic SEO: Build High-Intent Pages Without Thin Content
- Generative Engine Optimization (GEO) in 2025: Get Cited by AI
- 10-step framework for generative engine optimization
- I built a full SEO automation pipeline in n8n that updates my website daily
- City of Miami Developer Portal
- City of Orlando Open Data Portal
- Data Explorer - City of Miami
- The Complete Guide to SEO Automation with n8n Using AI Agents
- How I used n8n for programmatic SEO
- Claude MCPs and Prompts for SEO Blog Automation
- AI-powered product research and SEO content automation
- AI agents in SEO: A practical workflow walkthrough
- AI Search Content Optimization: The Complete Guide
- GEO: The Complete Guide to AI-First Content Optimization 2025
- SEO Automations are 10X Easier With Claude MCP
- What is Model Context Protocol?
- Seamless Frase Integration with Claude Code, Cursor, and More
- Top SEO MCP Servers in 2026: Tools and Use Cases
- Claude MCP Connector Guide: Setup, Auth and Top Use Cases 2026
- Google Search’s guidance about AI-generated content